Noindex y robots.txt no hacen lo mismo. La etiqueta noindex le dice a Google que no muestre una página en sus resultados, aunque la rastree. Un Disallow en el robots.txt le dice que no la rastree, pero no impide que la indexe. Para sacar una URL de Google se usa noindex; para ahorrar rastreo, Disallow.
El error típico es usar los dos a la vez, o usar el que no toca. Aquí tienes las diferencias, qué usar en cada caso y cómo retirar de Google una URL que ya está indexada.
Noindex o robots.txt: diferencias en una tabla
La diferencia entre noindex y robots.txt es que actúan en momentos distintos. El Disallow del robots.txt actúa antes de la visita: Google no entra en la URL. El noindex actúa después: Google entra, lee la instrucción y deja la página fuera de sus resultados. Uno controla el rastreo y el otro la indexación.
| Noindex | Disallow en robots.txt | |
|---|---|---|
| Qué controla | La indexación: que la URL salga o no en los resultados | El rastreo: que el bot visite o no la URL |
| Dónde se pone | En cada página (etiqueta meta robots) o en la cabecera HTTP (X-Robots-Tag) | En el archivo robots.txt de la raíz del sitio |
| ¿Google rastrea la URL? | Sí, lo necesita para leer la instrucción | No |
| ¿Puede salir en Google? | No, una vez que Google la ha vuelto a rastrear | Sí, si recibe enlaces: aparece sin descripción |
| ¿Ahorra rastreo? | No de forma directa | Sí |
| Para qué sirve | Sacar o mantener páginas fuera de Google | Evitar que los bots gasten peticiones en zonas sin valor |
Y hay una tercera opción que a veces se olvida: si el contenido es privado de verdad (un entorno de pruebas, documentación de clientes), ni noindex ni Disallow. Contraseña.
Rastreo e indexación: por qué no son lo mismo
Rastrear es que Googlebot visite una URL y descargue su contenido. Indexar es que Google decida guardar esa URL en su índice para poder mostrarla en los resultados. Una página puede estar rastreada y no indexada, y también, aunque suene raro, indexada sin haber sido rastreada.
Estos son los casos que me encuentro a menudo cuando reviso la indexación de una web:
- URLs con noindex. Google puede entrar y leer la página, pero si le dices «no me indexes», obedece. Sigue visitándola de vez en cuando para comprobar si la instrucción continúa ahí.
- URLs bloqueadas por robots.txt. Google no entra, pero si otras webs apuntan a esa URL puede indexarla igual. ¿El resultado? Aparece en Google sin contenido: solo la URL pelada.
- Canonical mal puesto. Si le dices a Google «esta página no es la buena, la buena es esta otra» (aunque no lo sea), es probable que te haga caso y se cargue la que querías posicionar.
La indexación es una decisión de Google basada en muchas señales. Tu trabajo es dárselas claras y sin contradicciones.
¿El noindex gasta presupuesto de rastreo?
El presupuesto de rastreo (crawl budget) es la cantidad de URLs que Googlebot puede y quiere rastrear en un sitio. Una URL con noindex se sigue rastreando, así que no ahorra presupuesto, pero tampoco penaliza. La guía de Google para gestionar el presupuesto de rastreo en sitios grandes lo deja claro: no uses noindex para ahorrar rastreo, porque Google pedirá la página igualmente y luego la descartará. Para eso está el robots.txt.
Esa misma guía está pensada para sitios muy grandes (habla de más de un millón de páginas) o con contenido que cambia a diario. En una web de unos cientos o miles de URLs, el presupuesto de rastreo no suele ser el problema, y lo que toca es elegir bien entre noindex y Disallow por lo que hace cada uno.
Qué es noindex y cómo se pone
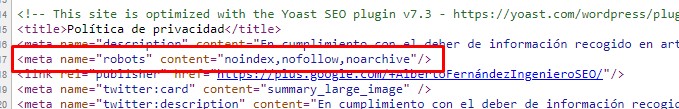
Noindex es una regla que indica a los buscadores que no incluyan una página en sus resultados. Se puede poner de dos formas: con una etiqueta meta robots en el HTML de la página o con la cabecera HTTP X-Robots-Tag. Las dos funcionan igual para Google; se elige una u otra según el tipo de archivo y el control que tengas del servidor.
Noindex con la etiqueta meta robots
Es la forma habitual en páginas HTML. Se añade en el <head>:
<meta name="robots" content="noindex">En WordPress, Shopify o PrestaShop no hace falta tocar código: los plugins y módulos SEO tienen una casilla por página o por tipo de contenido. Si solo quieres dirigirte a Google, puedes usar name="googlebot" en lugar de name="robots".
Noindex con la cabecera X-Robots-Tag
La cabecera HTTP X-Robots-Tag: noindex hace lo mismo desde el servidor, sin tocar el HTML. Es la única forma de aplicar noindex a archivos que no son páginas, como PDFs, documentos o imágenes. Por ejemplo, para todos los PDF en un servidor Apache (en el .htaccess):
<Files ~ "\.pdf$">
  Header set X-Robots-Tag "noindex, nofollow"
</Files>
Este ejemplo es el que da Google en sus especificaciones de la etiqueta meta robots y de X-Robots-Tag. En webs más complejas, como un CMS headless o una SPA (una aplicación de una sola página hecha con JavaScript), yo prefiero enviar el noindex por cabecera desde el backend: llega antes y no depende de que la página se renderice.
¿Funciona el noindex añadido con JavaScript o Google Tag Manager?
Sí, Google puede leer una etiqueta meta robots añadida con JavaScript, incluso desde Google Tag Manager, siempre que renderice la página. Lo que no es fiable es lo contrario: según los conceptos básicos de SEO para JavaScript de Google, si el HTML original lleva noindex, Google puede saltarse el renderizado y no llegar a ver que tu script lo quita.
Mi criterio: usa JavaScript para el noindex solo como parche temporal, cuando no hay forma rápida de tocar la plantilla o el servidor.
Por qué una página con noindex sigue apareciendo en Google
Si has puesto el noindex y la página sigue saliendo, suele ser por una de estas tres razones:
- Google todavía no ha vuelto a rastrearla. Las arañas pasan cada cierto tiempo, y en URLs poco importantes pueden tardar semanas o meses. Puedes pedir un nuevo rastreo con la inspección de URLs de Google Search Console (el antiguo formulario público para enviar URLs ya no existe).
- La URL está bloqueada en el robots.txt. Google no puede entrar, así que no ve el noindex. Hay que quitar el bloqueo.
- El noindex no está llegando a Google. Una caché que sirve la versión antigua, una etiqueta que solo se añade para usuarios registrados o un script que no se ejecuta. Compruébalo en la inspección de URLs, en «Ver página rastreada».
Qué hace Disallow en el robots.txt (y qué no)
La regla Disallow del archivo robots.txt impide que los rastreadores que la respetan visiten las URLs indicadas. No las borra de Google, no las protege y no transmite ninguna instrucción de indexación. Sirve para que los bots no gasten peticiones en zonas sin valor para el buscador: filtros, ordenaciones, buscador interno, carrito.
User-agent: *
Disallow: /buscar/
Disallow: /*?orden=
Google lo explica así en su introducción a robots.txt: el fichero sirve sobre todo para gestionar el tráfico de los rastreadores y no es un mecanismo para mantener una página fuera de Google. Si una URL bloqueada recibe enlaces, puede aparecer en los resultados sin descripción.
Otra cosa a tener en cuenta: el robots.txt es una recomendación, no una barrera. Los buscadores serios lo cumplen, pero si analizas los logs de tu servidor verás bots que no le hacen ningún caso. Por eso no vale para proteger contenido confidencial.
La sintaxis completa, los comodines, los ejemplos por CMS y cómo probar el fichero están en la guía del archivo robots.txt. Aquí me quedo con la comparación.
Por qué no debes combinar noindex y Disallow en la misma URL
Combinar noindex y Disallow en la misma URL hace que el noindex no sirva de nada. Si el robots.txt bloquea el acceso, Google no rastrea la página, no ve la etiqueta y la URL puede acabar indexada, o seguir indexada, igualmente. Google lo dice de forma expresa: para que el noindex funcione, la página no puede estar bloqueada por el robots.txt.
La fuente es la documentación de Google para bloquear la indexación con noindex. Y vale para cualquier instrucción que vaya en la página: si le prohíbes entrar, tampoco ve el canonical, ni el hreflang, ni los enlaces. No tiene sentido trabajar el etiquetado de una URL a la que el bot no puede acceder.
En Google Search Console este error se reconoce por el aviso «Se ha indexado aunque un archivo robots.txt la tenía bloqueada» del informe de indexación de páginas.
Noindex o Disallow: cuál usar en cada caso
Usa noindex cuando la página existe y es útil para el usuario pero no quieres que salga en Google. Usa Disallow cuando hay muchas URLs sin valor y lo que quieres es que los bots no pierdan el tiempo en ellas. Usa contraseña cuando el contenido es privado, y canonical cuando son duplicados de una página que sí quieres posicionar.
| Caso | Qué usar | Por qué |
|---|---|---|
| Página de gracias, landings de campaña | Noindex | Pocas URLs; no deben salir en Google |
| Buscador interno | Disallow | Genera URLs infinitas y no aporta nada |
| Filtros y ordenaciones del catálogo | Disallow (o canonical si son pocos) | Miles de combinaciones casi iguales |
| Carrito, checkout, área de cliente | Disallow (y acceso con login) | No hay nada que indexar |
| Entorno de pruebas | Contraseña | Ni noindex ni Disallow garantizan que no se filtre |
| PDFs que no quieres en Google | X-Robots-Tag: noindex | Un PDF no admite etiqueta meta |
| Etiquetas, archivos de autor o categorías vacías | Noindex | Contenido pobre o repetido, pero los enlaces se siguen leyendo |
| Paginaciones | Nada, por norma | Son el camino para descubrir productos y posts |
| Variantes duplicadas de una página | Canonical | Concentra las señales en la URL buena |
| Contenido caducado o eliminado | 404 o 410 (o redirección 301 si hay sustituto) | Es la señal más clara de que ya no existe |
| URL ya indexada que quieres retirar | Noindex primero; Disallow después, si hace falta | Google tiene que ver el noindex |
Las fichas agotadas de una tienda online son un caso con matices propios: mantenerlas, redirigirlas o eliminarlas depende de si el producto va a volver, y lo desarrollo en el protocolo SEO para productos sin stock.
Si antes controlabas los parámetros con la herramienta de parámetros de URL de Search Console, ya no existe: Google la retiró en 2022. Hoy los parámetros se gestionan con el robots.txt, el canonical y, sobre todo, no enlazándolos internamente.
¿No tienes claro qué bloquear y qué dejar indexar? Lo revisamos contigo sobre los datos de tu web (rastreo, logs y Search Console) antes de que un cambio mal planteado salga caro.
Cómo sacar de Google una URL que ya está indexada
Para sacar de Google una URL ya indexada, primero se le pone noindex y se deja que Google la rastree. Solo cuando ha desaparecido de los resultados tiene sentido bloquearla en el robots.txt. Hacerlo al revés, bloquear primero, es la forma más segura de que se quede indexada durante meses.
- Comprueba que la URL no está bloqueada en el robots.txt. Si lo está, quita la regla.
- Añade el noindex (meta robots o X-Robots-Tag). Si la página ya no debe existir, mejor un 404 o un 410.
- Facilita que Google vuelva a pasar. Pide el rastreo desde la inspección de URLs o, si son muchas, envía un sitemap con esas URLs. Tienes el proceso en cómo indexar una URL en Google, que para esto funciona igual.
- Si corre prisa, usa la herramienta de retiradas de Search Console. Oculta la URL en poco tiempo, pero es temporal: según la ayuda de Google sobre la herramienta de retiradas, dura unos seis meses, y para que sea definitiva hay que eliminar el contenido, protegerlo con contraseña o ponerle noindex. La misma página pide no usar el robots.txt como mecanismo de bloqueo.
- Comprueba el resultado en el informe de indexación de páginas: las URLs deben pasar al motivo «La URL se ha marcado como noindex». Cuando son cientos o miles, es más cómodo con un control de indexación masivo.
- Solo entonces, si quieres ahorrar rastreo, bloquea esas URLs en el robots.txt.
¿Cuánto tarda? Depende de cada cuánto rastree Google esas URLs. Google avisa de que puede tardar meses en volver a visitar una página, así que no hay un plazo que se pueda prometer.
¿Se puede poner noindex en el robots.txt?
No. Google no admite la regla noindex dentro del archivo robots.txt y lo indica de forma expresa en su documentación sobre noindex. Una línea Noindex: /pagina/ en el robots.txt se ignora, igual que cualquier otro campo que no sea user-agent, allow, disallow o sitemap.
Hubo un tiempo en que funcionaba de manera no oficial y por eso todavía se ve en ficheros antiguos. Google dejó de tenerla en cuenta en 2019. Tampoco existe un «nofollow» de robots.txt. Si quieres aplicar noindex a muchas URLs sin tocarlas una a una, la vía es la cabecera X-Robots-Tag configurada en el servidor por patrón de URL o por tipo de archivo: es lo más parecido a «un robots.txt para noindex».
Noindex, nofollow y otras directivas de la etiqueta meta robots
La etiqueta meta robots admite más reglas además de noindex. Las que Google usa hoy son nofollow, none, nosnippet, max-snippet, max-image-preview, max-video-preview, notranslate, noimageindex, indexifembedded y unavailable_after. Si no pones ninguna, se entiende que la página se puede indexar y sus enlaces se pueden seguir.
| Regla | Qué hace |
|---|---|
noindex | No mostrar la página en los resultados |
nofollow | No seguir los enlaces de la página |
none | Equivale a noindex, nofollow |
nosnippet | No mostrar fragmento de texto ni vista previa de vídeo |
max-snippet:[número] | Limitar los caracteres del fragmento |
max-image-preview:[none, standard o large] | Tamaño máximo de la vista previa de imagen |
unavailable_after:[fecha] | Dejar de mostrar la página a partir de una fecha (útil en campañas con caducidad) |
indexifembedded | Permitir indexar el contenido cuando va incrustado en otra página, aunque tenga noindex |
Algunas cosas que conviene saber:
index, followno hace falta. Es el comportamiento por defecto. En la mayoría de tus páginas la etiqueta meta robots sobra.noindex, followynoindex, nofollow. La primera pide no indexar pero seguir los enlaces; la segunda, ninguna de las dos cosas. Y una pregunta que te dejo: ¿para qué quieres un nofollow general en una página de tu propia web? Casi nunca hay un buen motivo.- Si dos reglas chocan, gana la más restrictiva. Con
max-snippet:50ynosnippeta la vez, se aplicanosnippet. - Google lee la etiqueta en cualquier parte de la página, no solo en el
<head>. Cuidado con los contenidos que insertan HTML de terceros. - Puedes dirigirte a un rastreador concreto. En la etiqueta meta, Google solo reconoce
googlebotygooglebot-newsademás derobots. - Las antiguas ya no cuentan.
noarchiveha dejado de usarse porque el enlace a la caché de Google ya no existe, ynoodponoydirhace años que no tienen efecto. Tampocorel="prev"yrel="next", que Google dejó de usar como señal. - No mezcles noindex con canonical hacia otra URL. Son señales contradictorias («no me indexes» y «soy igual que esta otra, que sí quieres indexar») y Google puede acabar haciendo lo contrario de lo que esperabas. Elige una.
Noindex y robots.txt con los rastreadores de IA
Con las IA se aplican las mismas dos capas. El robots.txt decide qué bots pueden rastrear tu web (GPTBot, ClaudeBot, PerplexityBot, Google-Extended), y las reglas de meta robots deciden cuánto contenido puede mostrar Google en sus resultados, incluidas las respuestas generadas con IA.
- Google-Extended no te saca de Google. Es el token de robots.txt con el que decides si tu contenido se usa para entrenar los modelos Gemini. Bloquearlo no afecta a tu presencia ni a tu posición en la búsqueda. Si quieres impedir ese uso:
User-agent: Google-Extended Disallow: / - Las respuestas con IA del buscador dependen de Googlebot y de meta robots. Según las especificaciones de la etiqueta meta robots de Google,
nosnippetevita que el contenido se use como entrada directa en las vistas creadas con IA y en el modo IA, ymax-snippetlimita cuánto se puede usar. - Cada empresa de IA tiene sus propios bots, unos para entrenamiento y otros para búsqueda. Qué user-agent corresponde a cada uno y cómo escribir las reglas está en el apartado de rastreadores de IA de la guía del robots.txt.
Errores habituales con noindex y robots.txt
Los errores más habituales con noindex y robots.txt son bloquear en el robots.txt una URL que lleva noindex, publicar una web nueva con el noindex del entorno de pruebas, bloquear CSS y JavaScript, y enviar en el sitemap URLs que están bloqueadas o marcadas como noindex. Todos mandan a Google señales contradictorias.
- Noindex y Disallow sobre la misma URL. El más repetido. Google no ve el noindex.
- Subir a producción el noindex o el
Disallow: /del entorno de pruebas. Pasa sobre todo en rediseños y cambios de plataforma, y puede tardar semanas en notarse. - Bloquear CSS y JS y luego extrañarse de que Google interprete mal la página. Necesita esos recursos para verla como un usuario.
- Poner
Disallow: /wp-admin/sin permitiradmin-ajax.php, que usan muchas funciones de WordPress en la parte pública. - Canonical y noindex juntos apuntando a sitios distintos.
- Sitemaps con URLs bloqueadas o con noindex. El sitemap es la lista de lo que quieres indexar; lo demás no pinta nada ahí.
- Usar el robots.txt para esconder algo confidencial. El fichero es público y no todos los bots lo respetan.
En mi experiencia auditando webs desde 2008, los que más daño hacen son los dos primeros, porque no dan ningún error visible: la web funciona, pero Google deja de verla como tú crees. Por eso, el día de un lanzamiento, comprobar el robots.txt y la etiqueta meta robots de las plantillas principales es lo primero que hacemos.
¿Tienes una migración o un rediseño a la vista? Muchos de estos errores aparecen justo al cambiar de web. Te acompañamos antes, durante y después del cambio para que no se pierda tráfico por el camino.
Cómo comprobar qué URLs tienen noindex o están bloqueadas
Para saber qué URLs de tu web tienen noindex o están bloqueadas por el robots.txt se usan tres fuentes: el informe de indexación de páginas de Google Search Console, un rastreo con una herramienta como Screaming Frog y, en webs grandes, los logs del servidor. Cada una responde a una pregunta distinta.
- El informe de indexación de páginas. En Google Search Console, este informe separa los motivos «La URL se ha marcado como noindex», «El archivo robots.txt ha bloqueado la URL» y el aviso «Se ha indexado aunque un archivo robots.txt la tenía bloqueada». Con la inspección de URLs ves el estado de una URL concreta.
- Un rastreo propio. Con Screaming Frog sacas en un listado todas las URLs con noindex (en la etiqueta o en la cabecera) y todas las bloqueadas por robots.txt, y puedes cruzarlas con el sitemap y con el enlazado interno.
- Los logs del servidor. Te dicen qué rastrea Googlebot de verdad, que no siempre coincide con lo que tú crees que rastrea.
En una auditoría miramos las tres, y en este orden: primero qué dice Google que ha hecho, luego qué le está diciendo la web, y por último qué está rastreando realmente.
Preguntas frecuentes sobre noindex y robots.txt
¿No está tu pregunta? Escríbeme a alberto@ingenieroseo.com y te contesto en menos de 24 horas.
¿Cuál es la diferencia entre noindex y robots.txt?
Noindex impide que una página aparezca en los resultados de Google, pero Google tiene que rastrearla para leer la instrucción. El Disallow del robots.txt impide el rastreo, pero no la indexación: una URL bloqueada puede aparecer en Google si recibe enlaces. Noindex controla la indexación y robots.txt controla el rastreo.
¿Puedo poner noindex en el archivo robots.txt?
No. Google no admite la regla noindex dentro del robots.txt y la ignora. El noindex se pone en la propia página con la etiqueta meta robots o en la respuesta del servidor con la cabecera X-Robots-Tag, y la URL no debe estar bloqueada en el robots.txt para que Google pueda leerlo.
¿Cómo pongo noindex a toda una web?
Para aplicar noindex a un sitio entero, envía la cabecera X-Robots-Tag: noindex en todas las respuestas del servidor o activa la opción equivalente de tu CMS (en WordPress, «Disuadir a los motores de búsqueda de indexar este sitio»). Un Disallow: / en el robots.txt no es lo mismo: bloquea el rastreo, pero no evita que las URLs se indexen. Si es un entorno de pruebas, usa contraseña.
¿Sigue teniendo sentido usar noindex, follow?
Sí, en páginas que no quieres en Google pero que enlazan a contenido que sí, como etiquetas o listados secundarios. Ten en cuenta que «follow» es el comportamiento por defecto, así que noindex a secas significa lo mismo. Si lo que buscas es que Google descubra bien tus páginas, el enlazado interno y el sitemap pesan más que esta etiqueta.
¿Cuánto tarda en desaparecer de Google una página con noindex?
Una página con noindex desaparece de Google cuando Googlebot vuelve a rastrearla y procesa la instrucción. En URLs que se rastrean a menudo pueden ser días; en URLs poco importantes, Google avisa de que puede tardar meses. Se puede acelerar pidiendo el rastreo en la inspección de URLs o, de forma temporal, con la herramienta de retiradas de Search Console.
¿Tienes un caso que no encaja en la tabla? Cuéntamelo en los comentarios, con el tipo de URL y lo que quieres conseguir, y te digo qué usaría yo.